Transcrire les débats parlementaires sans trahir la parole publique
Le compte rendu parlementaire n'est pas un problème de reconnaissance vocale : c'est un contrat de qualité. Anatomie d'une chaîne ASR + GED, de la captation audio à l'archive publiable.
À 19 h, la séance est levée. À 9 h le lendemain, le compte rendu doit être publiable. Entre les deux : des heures d'audio, une trentaine d'intervenants, des articles de loi cités de mémoire, des noms propres que personne n'écrit de la même façon, et des rédacteurs dont la signature engage l'institution.
J'ai travaillé sur une chaîne de gestion documentaire et de transcription automatisée des débats pour une assemblée nationale. Le projet m'a appris une chose que je n'avais pas vue venir : le modèle de reconnaissance vocale est la partie la plus simple. Tout ce qui l'entoure — la captation, le lexique, la validation humaine, l'archive — décide de la qualité perçue. Et c'est là que se joue le budget.
Cet article décrit l'architecture que je défendrais aujourd'hui, les erreurs qui coûtent cher, et les indicateurs que je mettrais en place dès la première semaine. Je ne donnerai pas les chiffres de production du client : ils ne m'appartiennent pas. Le raisonnement, lui, se transpose à toute institution qui doit publier la parole publique.
Un compte rendu n'est pas une transcription
Une transcription fidèle au mot près peut être impubliable. Un compte rendu doit être lisible, structuré, attribuable à un orateur, cohérent avec la procédure et conforme au style de l'institution. Ces exigences ne viennent pas du modèle : elles viennent du règlement intérieur, du service des comptes rendus et de la responsabilité juridique de ce qui est publié.
La conséquence pratique est simple : si vous évaluez votre projet uniquement sur le taux d'erreur de mots, vous allez optimiser le mauvais maillon. Vous allez acheter un modèle, alors que le travail est dans le processus.
Le contexte pèse plus que le modèle
Quatre contraintes reviennent dans tous les projets de ce type.
La salle. Les micros sont fixés aux pupitres, pas à la bouche. Il y a de la réverbération, des apartés, des applaudissements, des changements de président de séance. Un micro mal réglé ne se rattrape jamais en aval, quel que soit le modèle. La captation est un sujet d'ingénierie à part entière : niveau, redondance des sources, supervision continue, alertes.
Le temps. La promesse faite au public est un délai, pas une prouesse technique. Un compte rendu très précis livré trois jours plus tard ne rend pas le même service qu'un compte rendu bon livré le lendemain matin. Le délai se pilote comme une file d'attente : on mesure le temps d'attente, le temps de traitement et le temps de relecture séparément.
La souveraineté et la confidentialité. Des débats peuvent contenir des informations sensibles, des éléments de procédure, parfois des données personnelles. Envoyer des heures d'audio à un service externe n'est pas neutre : c'est une décision juridique autant qu'architecturale. C'est un point que l'Union interparlementaire documente explicitement dans son catalogue de cas d'usage, et que les institutions francophones traitent de plus en plus comme un critère de choix.
La charge de relecture. C'est la variable oubliée des budgets. Un taux d'erreur de 5 % peut représenter des heures de correction sur une séance longue. Ce coût humain est récurrent, il ne baisse pas avec la facture GPU.
La chaîne en six maillons
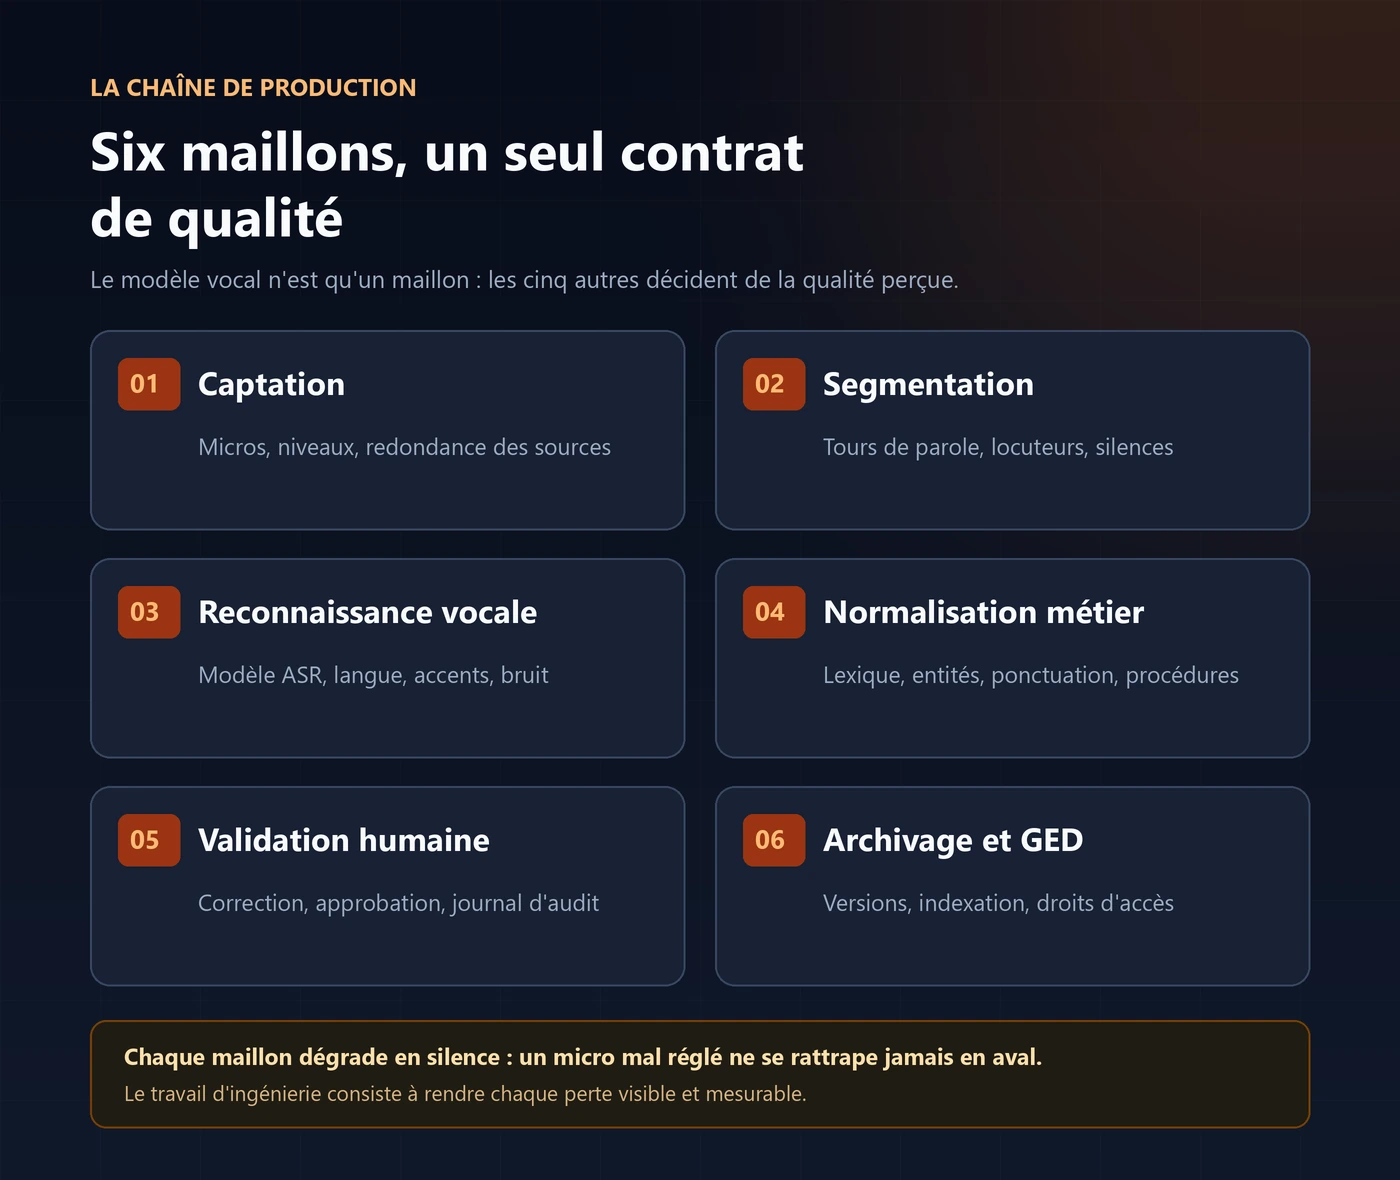
- Captation : micros, niveaux, redondance des sources, supervision.
- Segmentation : détection des tours de parole, identification des locuteurs, suppression des silences.
- Reconnaissance vocale : le modèle ASR, la langue, les accents, le bruit de fond.
- Normalisation métier : lexique, entités, ponctuation, mise au style de l'institution.
- Validation humaine : correction, approbation, journal d'audit.
- Archivage et GED : versions, indexation, droits d'accès, conservation.
Le maillon 3 est celui dont on parle dans les démonstrations. Les cinq autres décident si le résultat est utilisable un lundi matin.
Le lexique métier, là où se gagne la qualité
Le modèle se trompe rarement sur la grammaire. Il se trompe sur ce qui compte : les noms d'élus, les titres, les numéros d'articles, les montants, les noms d'institutions, les sigles. Sur un texte qui fait foi, une erreur de nom propre coûte plus cher que dix erreurs d'accord.
Trois mécanismes, testés dans cet ordre, font l'essentiel du gain :
- Un lexique versionné construit avec les rédacteurs, pas avec les seuls développeurs. Il contient les entités, leurs variantes, les formes fautives observées et la correction attendue.
- Une post-correction déterministe appliquée avant la relecture : règles sur les entités, les nombres, les dates, les formules de procédure. Chaque règle est testée, et chaque application est journalisée.
- Un contrôle de différence entre la version brute et la version corrigée, pour que le relecteur voie ce que la machine a touché — et puisse le refuser.
Ce travail paraît ingrat. C'est pourtant lui qui transforme un prototype convaincant en outil de production.
Le WER ne dit pas si le texte est publiable
Le taux d'erreur de mots (WER) est une moyenne. Une moyenne cache exactement ce qui vous intéresse : la distribution des erreurs. Un système peut afficher un WER correct et massacrer tous les noms propres.
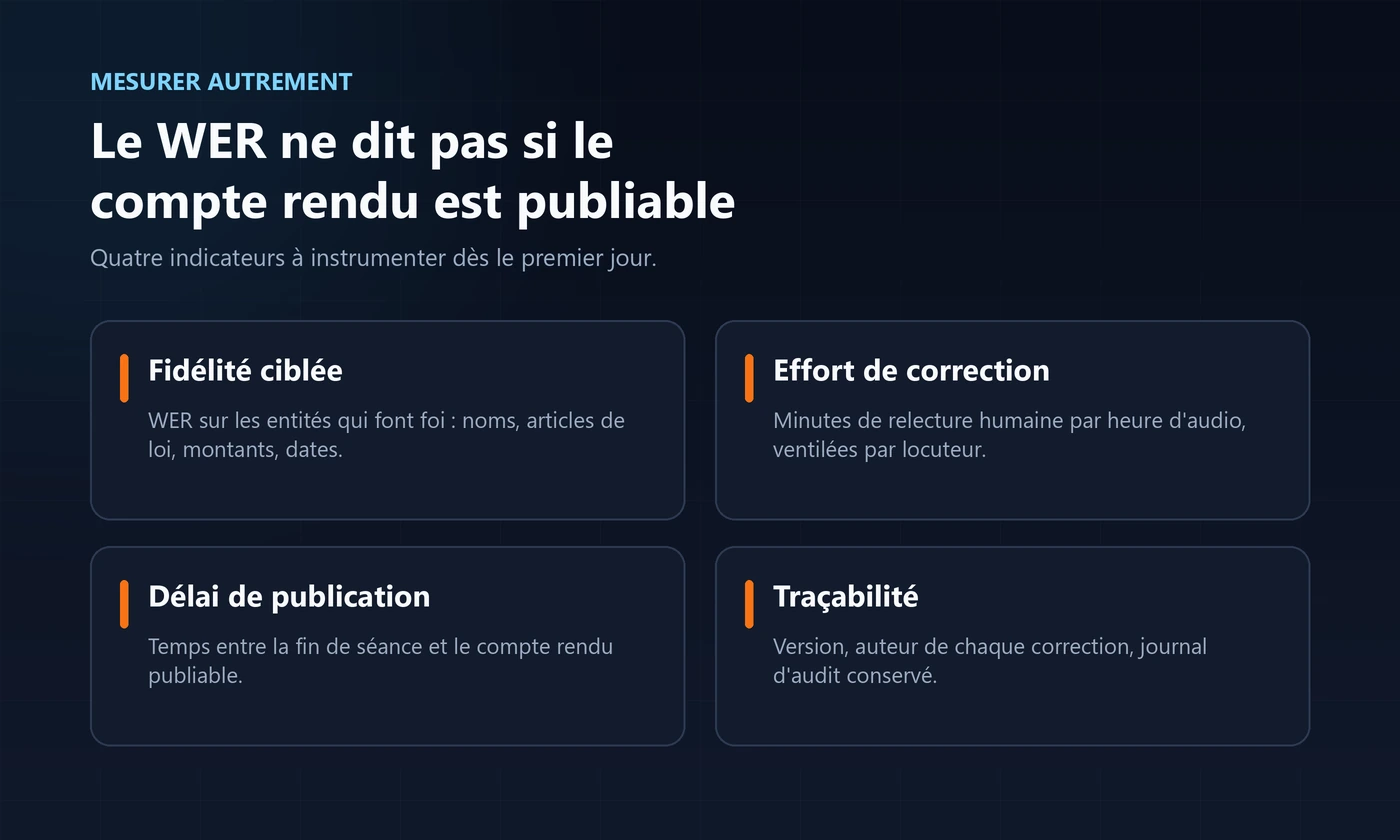
Je mesure quatre choses :
- La fidélité ciblée : le taux d'erreur restreint aux entités qui font foi (noms, articles de loi, montants, dates).
- L'effort de correction : minutes de relecture par heure d'audio, ventilées par locuteur et par condition de captation.
- Le délai de publication : temps entre la fin de séance et le compte rendu publiable.
- La traçabilité : version, auteur de chaque correction, journal d'audit conservé.
Pour que ces chiffres aient un sens, il faut un jeu d'évaluation stable : 30 à 60 minutes d'audio stratifiées par type de séance, de locuteur et de qualité sonore, transcrites manuellement une fois, puis réutilisées à chaque évolution du pipeline. Sans ce jeu, on ne compare que des impressions.
GPU dédié, API externe ou hybride
GPU dédié
Points forts : confidentialité des données, coût marginal stable, contrôle total du modèle. Limites : exploitation, files d'attente, dimensionnement matériel, compétences à maintenir. À choisir quand les données ne peuvent pas sortir du périmètre de l'institution.
API externe
Points forts : mise en route rapide, qualité immédiate, aucune opération d'infrastructure. Limites : coût variable à l'heure d'audio, données traitées hors du périmètre, dépendance à un fournisseur. À choisir quand le volume est faible ou que la phase d'expérimentation prime.
Hybride
Points forts : pré-traitement local, appel externe limité aux segments filtrés, possibilité de repli. Limites : deux chaînes à superviser, complexité d'exploitation. À choisir quand on veut la qualité du meilleur modèle sans tout exposer.
La GED n'est pas un placard
Un compte rendu n'est pas un fichier PDF posé dans un dossier. C'est un document lié à une séance, à des intervenants, à des textes, avec des versions successives et un statut. Trois exigences à ne pas négliger :
- Versions et audit : qui a corrigé quoi, quand, avec quelle justification. Sans journal, aucune validation ne tient devant un contrôle.
- Recherche : l'indexation doit porter sur les entités, les dates et les textes cités, pas seulement sur le texte brut. C'est ce qui rend l'archive utile au-delà de la publication.
- Droits d'accès : les brouillons, les versions validées et les pièces jointes n'ont pas le même public. Un annuaire d'identités centralisé (par exemple Keycloak) évite de réinventer les rôles dans chaque application.
Et une question à poser très tôt : où est la sauvegarde, et a-t-on déjà testé une restauration ? Une promesse de conservation sans test de restauration est une promesse non tenue.
Ce que j'en retiens
- Mesurer l'effort de correction, pas seulement le taux d'erreur du modèle.
- Traiter la captation comme un composant logiciel : supervision, alertes, redondance.
- Construire le lexique métier avec les rédacteurs, pas seul.
- Versionner chaque correction, avec auteur et horodatage.
- Tester la restauration de l'archive avant de promettre la conservation.
- Garder l'approbation humaine explicite et tracée : c'est elle qui rend la publication défendable.
- Budgéter la relecture, pas seulement le GPU.
- Documenter les décisions d'architecture pour l'équipe qui reprendra le projet.
Le débat public a besoin de comptes rendus accessibles, rapides et exacts. L'IA rend ce travail possible à une échelle qui ne l'était pas il y a cinq ans, mais elle ne supprime pas la responsabilité éditoriale. C'est exactement pour cela que le sujet est intéressant : la partie difficile n'est pas la démonstration, c'est la production.
Sources
- Sénat : usage de l'intelligence artificielle à l'étude pour les comptes rendus des débats, Public Sénat, avril 2025
- Union interparlementaire, cas d'usage de l'IA dans les parlements, décembre 2024
- Union interparlementaire, comptes rendus Hansard automatisés
- Togo First, numérisation de l'Assemblée nationale, juin 2025
- Hackathon 2026 de l'Assemblée nationale, défi AnIA SCRIPT
- Archimag, capture, GED et IA dans le secteur public, septembre 2026
- Documentation OpenAI Whisper, modèles et besoins matériels